
微软近日公开的一项专利申请引发广泛关注。根据专利文件描述,公司正在研究一种能够在直播过程中实时修改发言内容,并同步调整说话者嘴部和面部动作的人工智能系统,从而让观众看到经过修改后的自然视频画面。
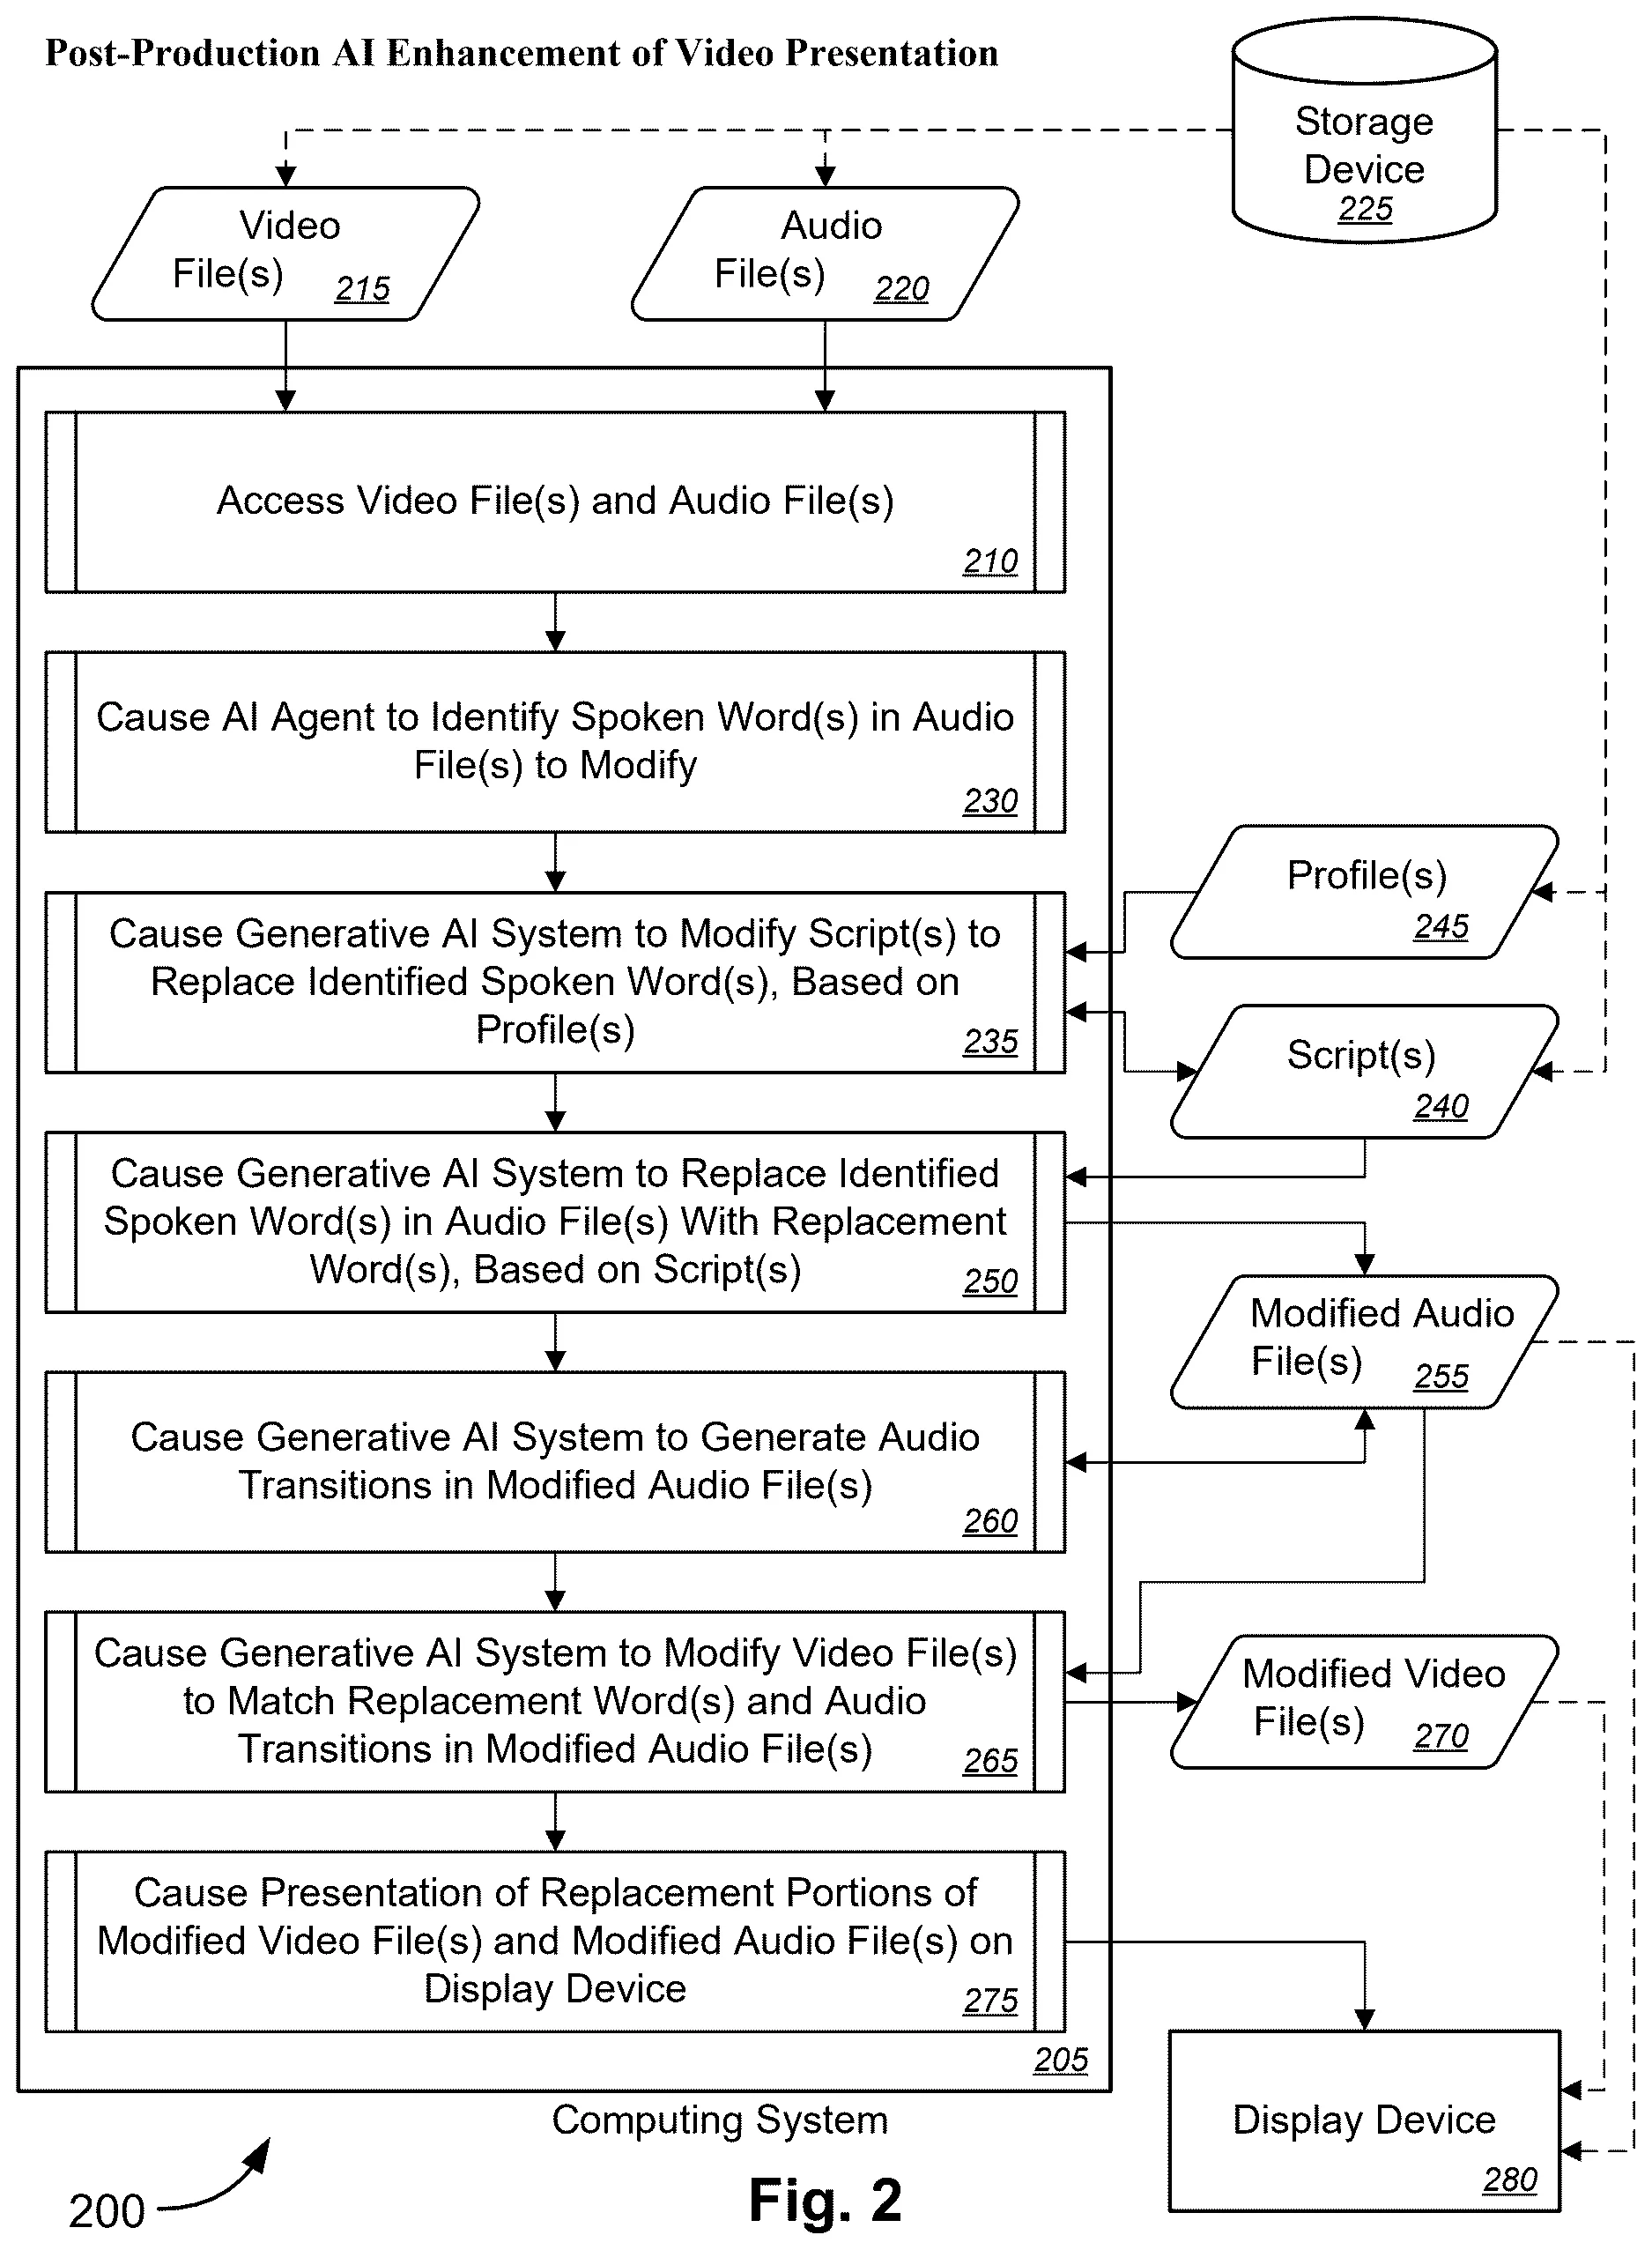
这项专利名为“实时人工智能增强视频或增强现实直播呈现技术”,最初于2025年4月提交,并于2026年10月正式公开。文件显示,该系统不仅能够修改直播中的语音内容,还能够利用生成式人工智能对视频画面进行处理,使人物口型与修改后的语音保持一致。
按照专利描述,系统会持续监听直播音频流,通过AI代理自动识别需要调整的词汇或短语。当发现目标内容后,生成式人工智能会对音频进行替换、删除或重写,同时修改相关视频帧中的面部动作、嘴唇形状以及口部运动轨迹,从而让最终画面看起来像是演讲者原本就说出了修改后的内容。
微软在文件中将整个过程定义为“近实时”处理,意味着从内容采集到修改完成仅存在数秒延迟。相关方案既可应用于后期处理,也能够用于直播场景。
专利列举了多种潜在应用场景。其中最主要的用途之一是实时翻译。系统可以将演讲者的发言即时翻译为观众的母语,并让视频中的口型同步匹配翻译后的内容,从而避免传统配音或字幕带来的违和感。
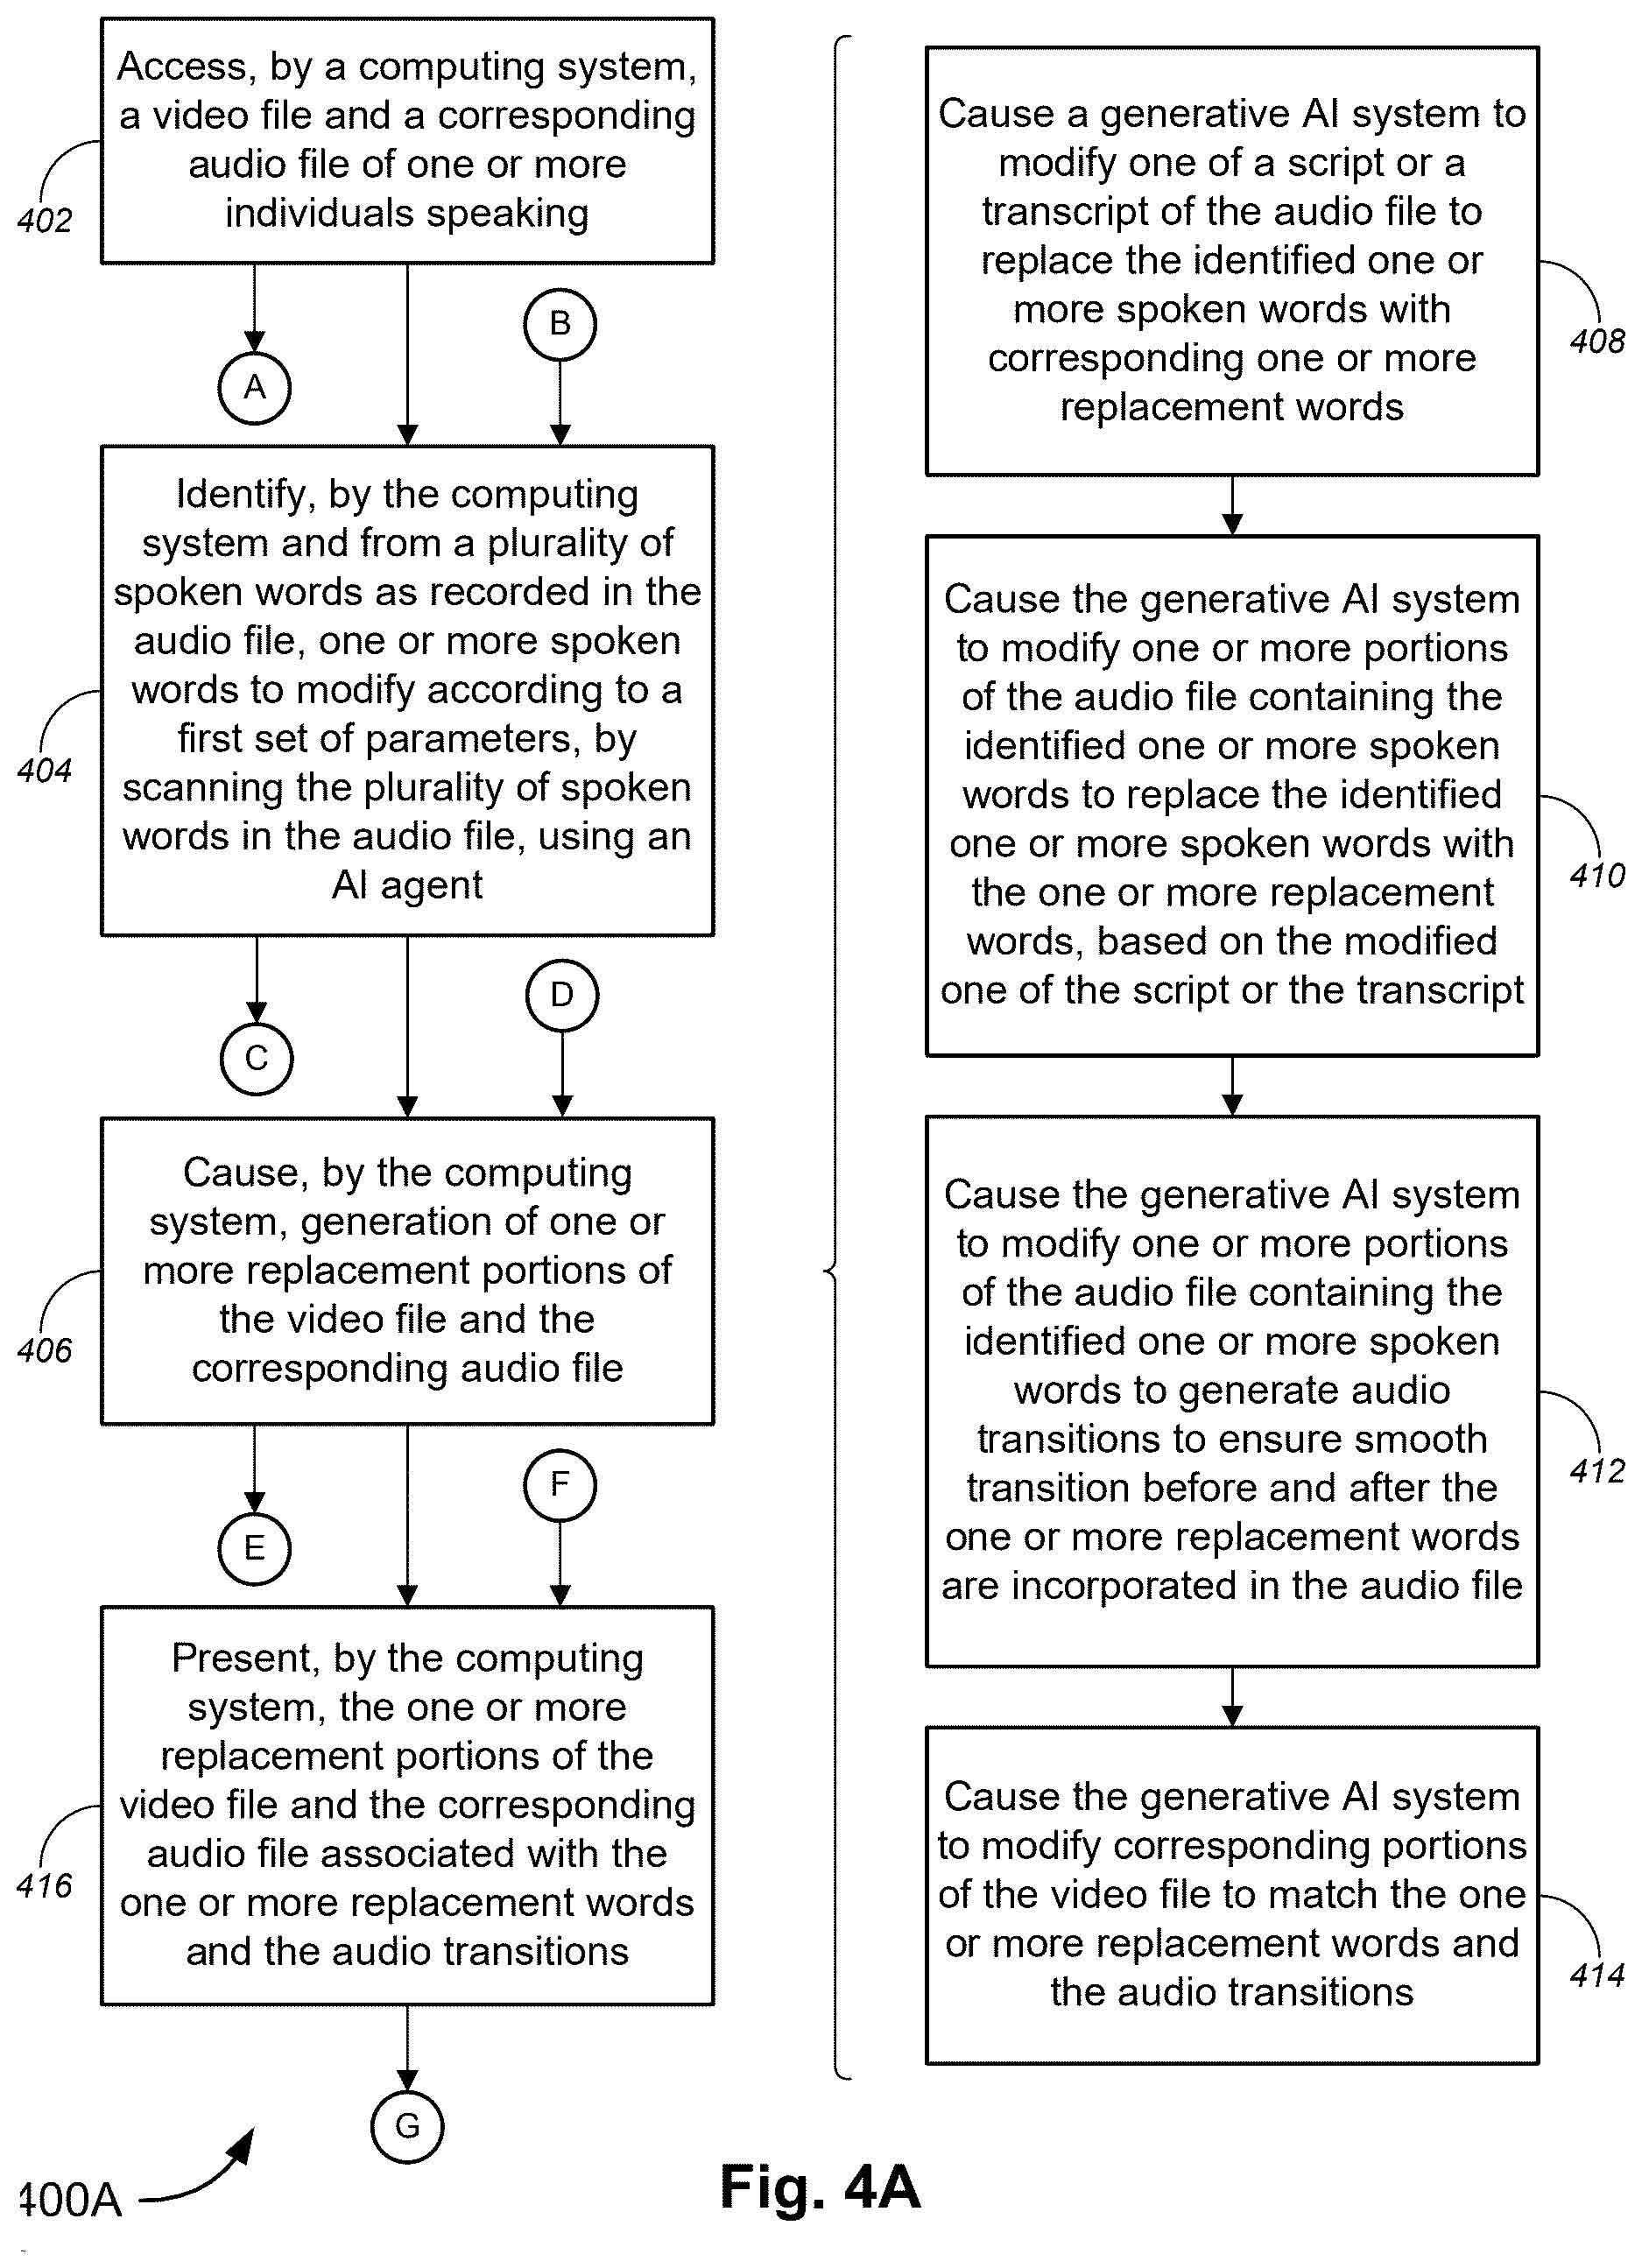
除此之外,系统还能够自动删除“嗯”“啊”等口头禅和填充词,修正口误、发音错误以及表达不准确的内容,使演讲内容更加流畅自然。专利还提到,系统可根据观众偏好过滤粗俗语言、敏感词汇、冒犯性表达以及部分地区方言词语,为不同群体提供定制化内容呈现。
在某些配置下,替换内容甚至可以通过网络搜索自动生成,以便实时寻找更加准确或更符合上下文的表达方式。
微软还设想将该技术应用于讲座、颁奖典礼、体育赛事转播、烹饪节目以及各类直播电视节目中。通过自动修正发言内容和表达方式,可以减少人工后期剪辑工作量,提高内容制作效率。
不过,这项技术同时引发了关于信息真实性的讨论。由于系统能够在直播过程中直接改变发言者最终呈现给观众的话语内容,一些分析人士担忧该技术未来可能被用于改变政治人物发言、企业声明甚至新闻报道内容,从而增加虚假信息传播风险。
对于这一问题,微软在专利中也提出了相应方案。文件显示,系统将保留未经修改的原始音频和视频作为“基础事实记录”,以便在出现争议、调查或法律需求时进行核验。部分方案还提及通过数字标识等方式保留修改痕迹。
值得注意的是,目前公开的仅是一项专利申请,并不代表微软已经推出相关产品,也不意味着相关技术一定会最终商业化。科技行业长期存在大量未被实际应用的专利构想,因此该系统是否会出现在未来产品中仍有待观察。
不过,随着生成式人工智能和实时视频处理能力不断提升,这项专利展示了未来直播技术可能的发展方向。在提高翻译和内容优化效率的同时,如何平衡便利性与内容真实性,也将成为未来人工智能应用面临的重要议题。