
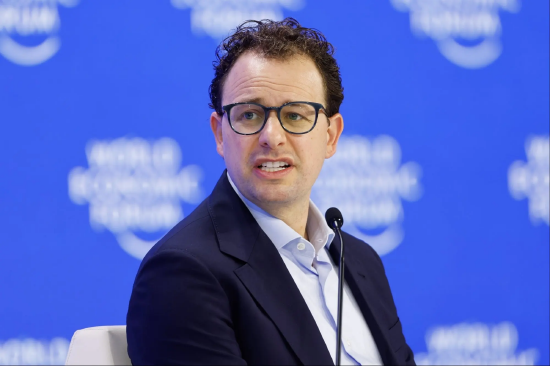
Anthropic首席执行官达里奥·阿莫代伊呼吁控制前沿人工智能模型能力提升的速度,为安全评估和防护措施争取时间。他提出引入常驻独立评估人员、协调主要开发商的安全标准,并推动跨国风险管控合作。
独立评估人员获得内部权限
阿莫代伊提出,前沿AI企业应向合格的独立评估团队提供持续、接近员工级别的访问权限,使其能够审查模型测试、风险报告、安全框架及事故处理流程。
Anthropic承诺率先实施该措施。外部人员将获得与公司风险评估团队相近的权限,并可在不受Anthropic编辑控制的情况下公布结论。
这一安排仍需解决评估人员的遴选、经费来源和保密责任等问题。模型权重、训练基础设施及安全漏洞属于高度敏感信息,扩大访问权限也会增加信息安全要求。
行业协调限制无保护的能力竞赛
第二项建议要求主要AI实验室就风险测试、安全门槛和模型发布条件形成共同标准。阿莫代伊认为,竞争压力可能促使企业加快训练及发布节奏,使防护措施难以及时跟上模型能力。
Anthropic的“负责任扩展政策”已采用分级机制。当模型跨越生物、网络、自动化研发或失控风险门槛时,公司需要提高部署保护和信息安全等级。
企业间合作可能涉及反垄断边界。共同制定安全测试标准具有公共利益,但相关安排若限制较小企业进入市场、协调产品发布或削弱竞争,仍可能受到监管审查。
国际合作覆盖跨境风险
第三项建议涉及政府间合作,包括与中国等战略竞争方建立最低限度的安全安排。阿莫代伊认为,模型和技术能够跨境流动,单一国家或企业放慢开发速度,可能导致高风险研发转移至监管较弱的地区。
Anthropic列出的潜在风险包括利用模型协助生物武器活动、大规模发现软件漏洞、攻击关键基础设施,以及AI系统脱离开发者控制。AI自动参与下一代模型研发,也可能进一步加快能力提升。
公司提出,前沿开发商应公布系统卡及定期风险报告、接受独立审查,并向指定政府机构提供必要信息。对于可能造成灾难性损害的模型,政府应拥有阻止或延迟部署的有限权力,同时建立明确门槛和申诉机制。
行业支持尚未转化为协议
OpenAI首席执行官萨姆·奥尔特曼支持赋予独立评估人员内部访问权限,并表示OpenAI将采取类似安排。Google DeepMind首席执行官德米斯·哈萨比斯和xAI负责人埃隆·马斯克也公开支持阿莫代伊提出的总体方向。
相关表态尚未形成具有约束力的行业协议。哪些能力指标会触发减速或暂停、独立审查是否具有强制效力,以及跨国协议如何执行,仍待企业和政府进一步确定。