
10月6日,OpenAI一口气公开了722篇由内部AI模型生成的数学手稿。仅过一天,其中3篇就被宣布撤回。让三篇手稿一起翻车的,居然只是一处正负号错误:一篇出了错,另外两篇沿用了同一套构造,也被一并撤回。AI批量交卷之后,两大巨头联手为“验卷”买单。
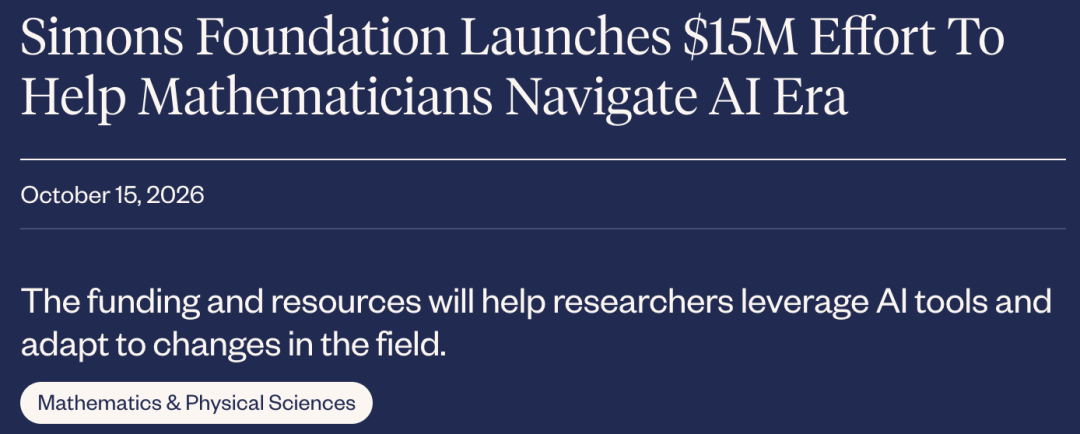
10月15日,Simons基金会宣布,与OpenAI、Anthropic共同承诺1500万美元的资金及资源,支持数学家检验、理解并拓展AI成果。
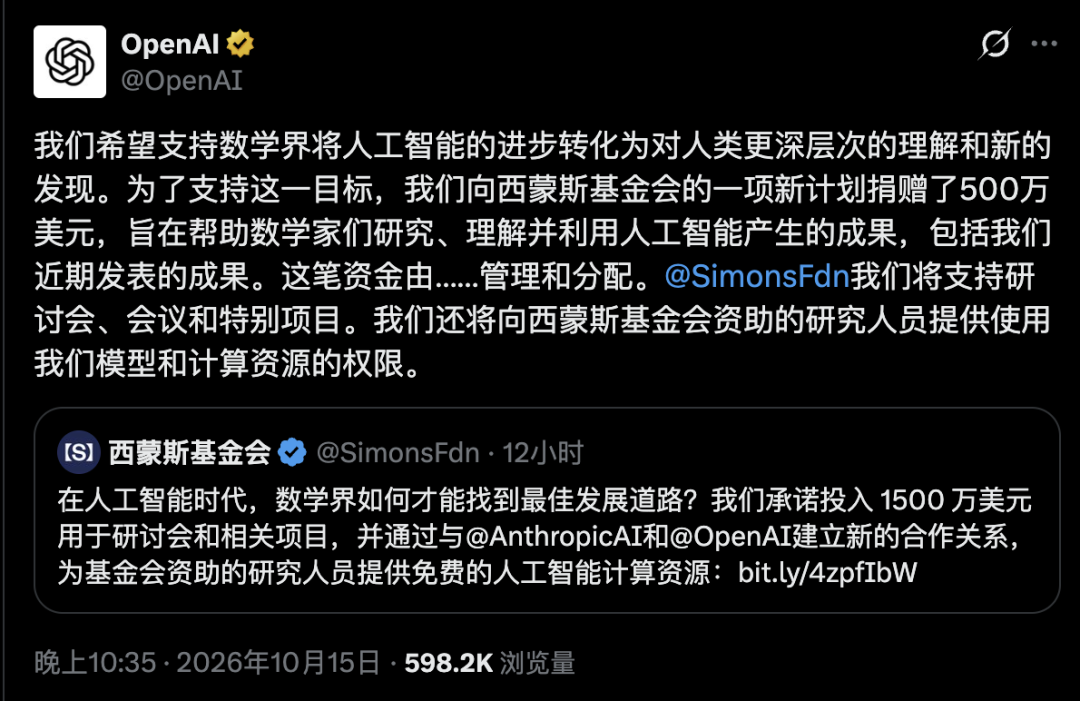
OpenAI出资500万美元,另外提供模型和算力,希望将AI的进展转化为更深入的人类理解和新发现。
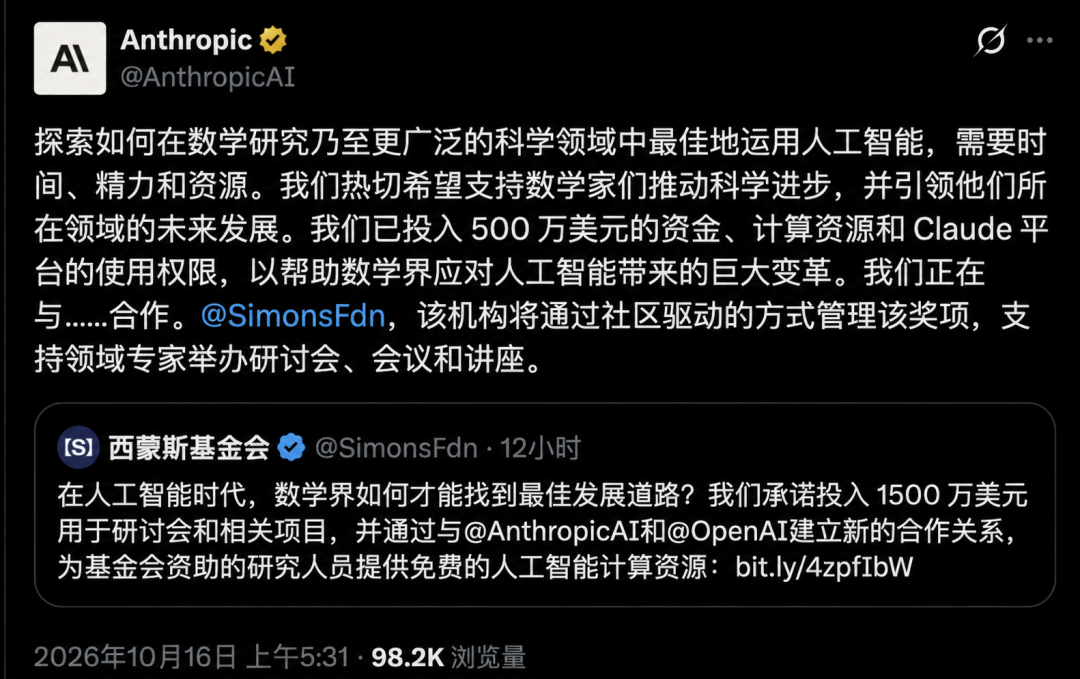
Anthropic承诺的500万美元支持,包含资金、算力和Claude使用权限。它也坦言:在数学乃至更广泛的科学研究中用好AI,需要时间、精力和资源。
相关资助由Simons基金会管理,用于工作坊、会议等活动。
说白了,就是支持数学家给AI验卷,把那些长篇证明读懂、讲清,再把有价值的方法用起来。
近几个月,OpenAI在数学界接连掀起“剧震”:
先公布10项涉及长期开放问题的研究成果,再宣布给出千禧年大奖难题——纳维–斯托克斯问题的证明,随后又集中发布数百篇数学手稿。
成果如潮水般涌来,人类有点“消化不良”了。
陶哲轩一针见血地指出,数学正从“证明稀缺”走向“证明充裕”,但人类的验证与理解能力未必跟得上。
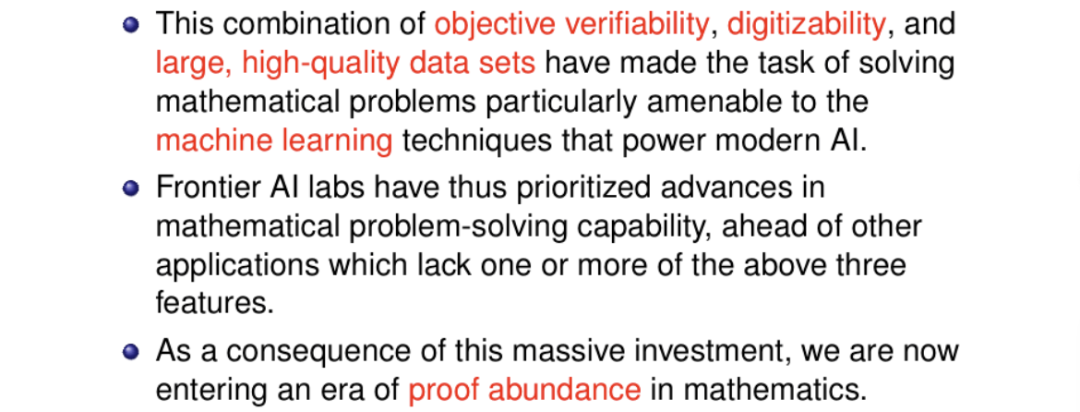
陶哲轩在讲稿中提出“证明充裕的时代”。
MIT工程教育副院长Justin Solomon在播客节目里坦言,OpenAI那篇纳维–斯托克斯证明,自己读过开头几页,就读不下去了。
Solomon在《Odd Lots》播客中坦言,面对OpenAI给出的纳维–斯托克斯证明,自己连开头几页都没能读下去。
AI能快速生成长篇推导,人类的理解却不会随之自动生成。
722篇手稿
从“写出来”到“读得懂”
10月6日,OpenAI在GitHub公开这批来自内部未发布模型的成果,次日就在更新日志里留下了撤回3篇、修订14篇的尴尬记录。
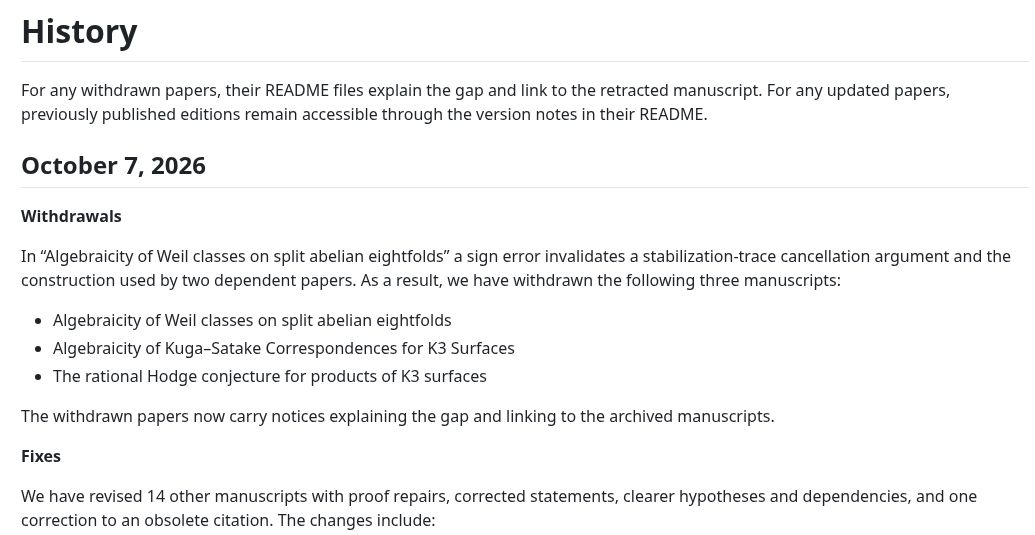
10月7日更新日志:撤回3篇手稿,修订另外14篇。
问题出在一处符号:
按照论文约定本该取-1,AI在证明中却按+1计算。纠正后原以为归零的计数并不为零,所用定理的前提直接崩塌。
另外两篇手稿用了同一套方法,也被一并撤回,其中一篇研究的是K3曲面乘积的有理霍奇猜想。
这批成果来自模型对约4000道问题的尝试与筛选。数量惊人,验证却还没跟上:
约42%的主要结果配有Lean形式化材料,可供计算机检查推理过程。部分尚未形式化的结果,仍可能存在问题。
就算证明本身没问题,研究也没有结束。
光知道算对了还不够,还要明白是怎样算对的:关键方法是什么?适用条件能否放宽?能不能用它解决其他问题?
做数学研究,作者得看懂自己的证明,也得为它负责。
但AI可能写出一长串推导,连给它出题的研究员都看不懂,更别说检查对不对。
所以,找出错误只是一步。
更关键的是把里面有用的方法讲清楚,让别人学得会、用得上,能接着往下研究。
学术界的火气
1500万美元能解决多少?
这也彻底点燃了学术界的火气。
大家争论的,已不只是三篇手稿有没有错,而是AI一口气交出这么多成果,谁来花时间查错、读懂,再把研究接着做下去?
10月7日,人类数学协会AHM发表严厉声明,批评这种一次性倾倒七百多个文件的行为是在“展示权力”,甚至呼吁数学家停止与OpenAI合作。
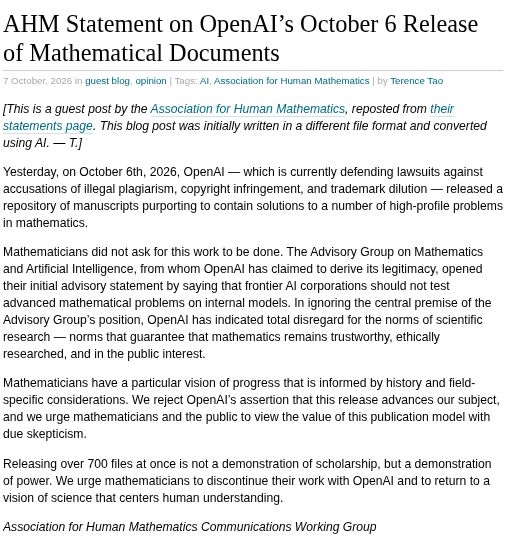
陶哲轩博客刊登的AHM客座声明,保留工作组署名。
这份由协会传播工作组署名的声明,也被陶哲轩作为客座文章发在了自己的博客上。
康奈尔大学数学家Alex Townsend的建议很直接:
OpenAI应该先发布经过Lean验证的手稿,其他材料单独放出来,请大家帮忙检查,别把验证过的和还没验证的混在一起。
MIT高级研究科学家Andrew Sutherland肯定了OpenAI迅速纠错的态度,但也表示,想要重新赢得信任,还需要更多工作。
大家担心的是:AI公司用学界拿不到的内部模型,抢先做出成果;数学家却因为缺少同样的工具,反而跟不上自己领域的进展。
AI公司一口气放出大批手稿,查错、读懂的重担,却落到了人类研究者身上。
普林斯顿高等研究院的顾问组(AGMAI)早在9月底就提出:AI实验室不能只顾着发布成果,也要出钱、出资源,支持人类把这些成果读懂。
OpenAI和Anthropic这次联手提供支持,正好回应了学术界此前的诉求。
但这些支持不等于买断话语权:学术界接受支持,也不代表学术界认可AI实验室的所有做法。
这1500万美元究竟该怎么花?
按照公告,基金会会公开征集项目,支持研究者检查AI成果、学习新工具,一起讨论这些工具该怎么用、按什么标准用。
AGMAI此前也建议,可以围绕复杂证明办暑期学校,或组织长期合作的研究小组,让大家有时间和资源把AI写的长篇证明一步步拆开、讲明白。
Simons基金会主席David Spergel也强调:
这些讨论必须由数学共同体主导。
AI公司可以提供资源,但研究什么、如何验证、下一步往哪里走,依然是人类说了算。
学术圈接受资助,也要保留质疑和独立判断的空间。
AI批量交卷
人类继续发掘知识
David Spergel在公告里强调,数学不应只被看作证明和定理的集合,更是由人类好奇心推动的集体理解。
当AI能批量产出研究材料,衡量科学进展,也必须把后续工作算进去。
不能只惊叹AI写出了多少篇论文,更要追问:哪些结果经得起检查?别人能否理解并继续使用?这些成果带来了什么新的探索方向?
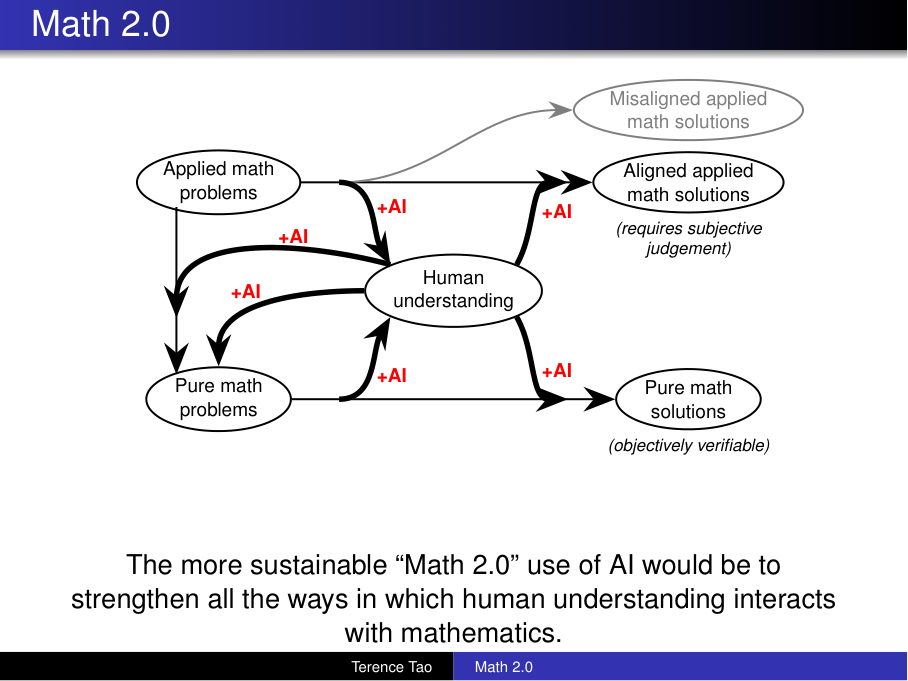
陶哲轩的Math 2.0示意图,将“人类理解”置于中心。
而这场讨论,也已经伸向数学之外。
Simons公告明确提到,OpenAI和Anthropic提供的工具和算力,还会用到数学之外的基础科学研究中。
谁来查错、谁能看懂、出了问题谁负责,其他学科也得提前想一想。
近日,理论物理测试里就出现了一个反转:
GPT-6 Astra被判错,专家复核后却发现,部分参考答案本身有错。修正后,Astra在TheoPhysEval的50道研究级题目中答对49道,正确率达到98%。
AI的答案要查,专家的参考答案,同样要查。
再把复杂推导讲清楚,让别人看得懂、用得上,这些成果才能成为下一次发现的起点。
参考资料:
https://x.com/OpenAI/status/2110741355739963884
https://www.simonsfoundation.org/news/simons-foundation-launches-15m-effort-to-help-mathematicians-navigate-ai-era/
https://openai.com/index/sharing-ai-progress-in-mathematics/
https://x.com/AnthropicAI/status/2110846112152105136?utm_source=chatgpt.com