联合国近日宣布与Google展开合作,计划让庞大的全球统计数据体系更容易被人工智能系统访问和使用。这项合作的目标不仅是帮助人类用户更便捷地获取数据,也是在为不断兴起的AI智能体时代建设可靠的数据基础设施。
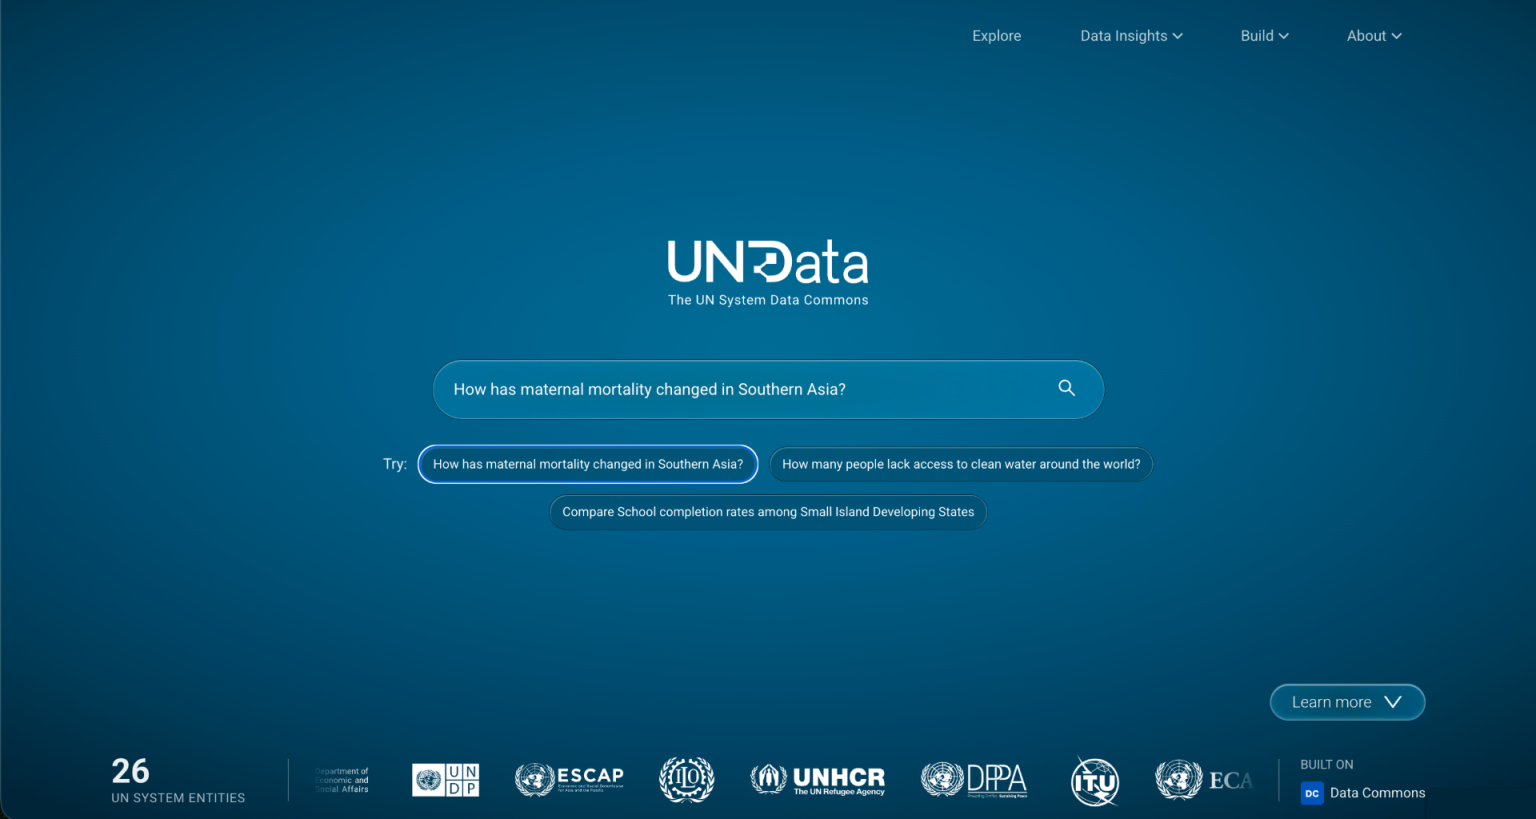
此次推出的新平台名为“联合国系统数据共享平台(UN System Data Commons)”。该系统基于Google开源的Data Commons技术构建,允许用户通过自然语言直接查询来自多个联合国机构的统计信息,而无需像过去那样在传统数据库界面中逐层查找和筛选数据。
新平台将取代现有的UNData门户。相比旧系统主要依赖关键词搜索和数据库浏览方式,新平台更加适应人工智能工具和自然语言交互环境。用户未来可以直接以日常提问方式查找全球发展、人口、教育、健康、经济等领域的数据。
更重要的是,该系统支持当前人工智能领域广泛关注的模型上下文协议(MCP)。这一技术标准能够使人工智能模型直接连接外部数据源,从而让AI智能体在执行分析、研究与查询任务时,直接调用联合国官方统计数据,而不是依赖不稳定或未经验证的信息来源。
联合国推动这一项目的重要原因,是越来越多研究显示当前主流AI模型在处理权威统计数据时仍然存在明显问题。
联合国儿童基金会近期开展的一项测试显示,包括OpenAI、Anthropic以及Google在内的多家公司大语言模型,在回答全球发展指标相关问题时表现并不理想。测试覆盖超过13.3万个回答样本,而六款主流大语言模型的平均准确率仅为21.2%。
研究人员发现,大约六成回答甚至未能给出可用数字。许多模型倾向于使用模糊措辞回避回答,即使能够提供数字结果,不同时间重复提出相同问题时,模型给出的答案也经常出现变化。
参与测试的模型包括GPT-4o、GPT-4o-mini、Claude Sonnet 4.5、Claude Haiku 4.5、Gemini 2.5 Flash以及Gemini 2.0 Flash。研究团队认为,这种情况反映出当前人工智能系统在调用全球发展数据时仍面临严重的可靠性挑战。
与此同时,联合国儿童基金会还观察到另一个重要趋势:越来越多用户已经通过人工智能工具而非传统搜索引擎访问统计数据。
数据显示,今年以来,通过ChatGPT等人工智能工具跳转至联合国儿童基金会数据网站的访问量同比增长67%。目前,来自人工智能助手的访问已经占该网站总流量的大约十分之一。对于一个每月访问量超过600万人次的数据平台而言,这一变化显示用户获取信息的方式正在迅速转变。
在这样的背景下,联合国意识到,仅仅发布数据已经不再足够。如果希望未来的人工智能系统能够准确引用权威统计数据,就必须主动让这些数据具备机器可读、AI可访问和智能体可调用的能力。
目前已有26个联合国机构承诺加入这一新平台,其中接近20个机构的数据已经在系统上线时开放使用。未来随着更多机构接入,平台预计将汇集联合国体系内覆盖经济、社会、环境、教育、健康和可持续发展等多个领域的大规模官方统计资源。
联合国表示,希望通过这项计划让全球研究人员、政策制定者、企业以及普通公众获得更可靠的数据基础,同时确保未来越来越多依赖AI完成分析和决策的系统能够建立在权威事实基础之上,而非不稳定或错误的信息来源。
随着人工智能逐步成为人们获取知识和查询信息的重要入口,联合国此次与Google合作,也被视为国际组织首次系统性地为“AI智能体时代”建设官方数据基础设施的重要尝试。