
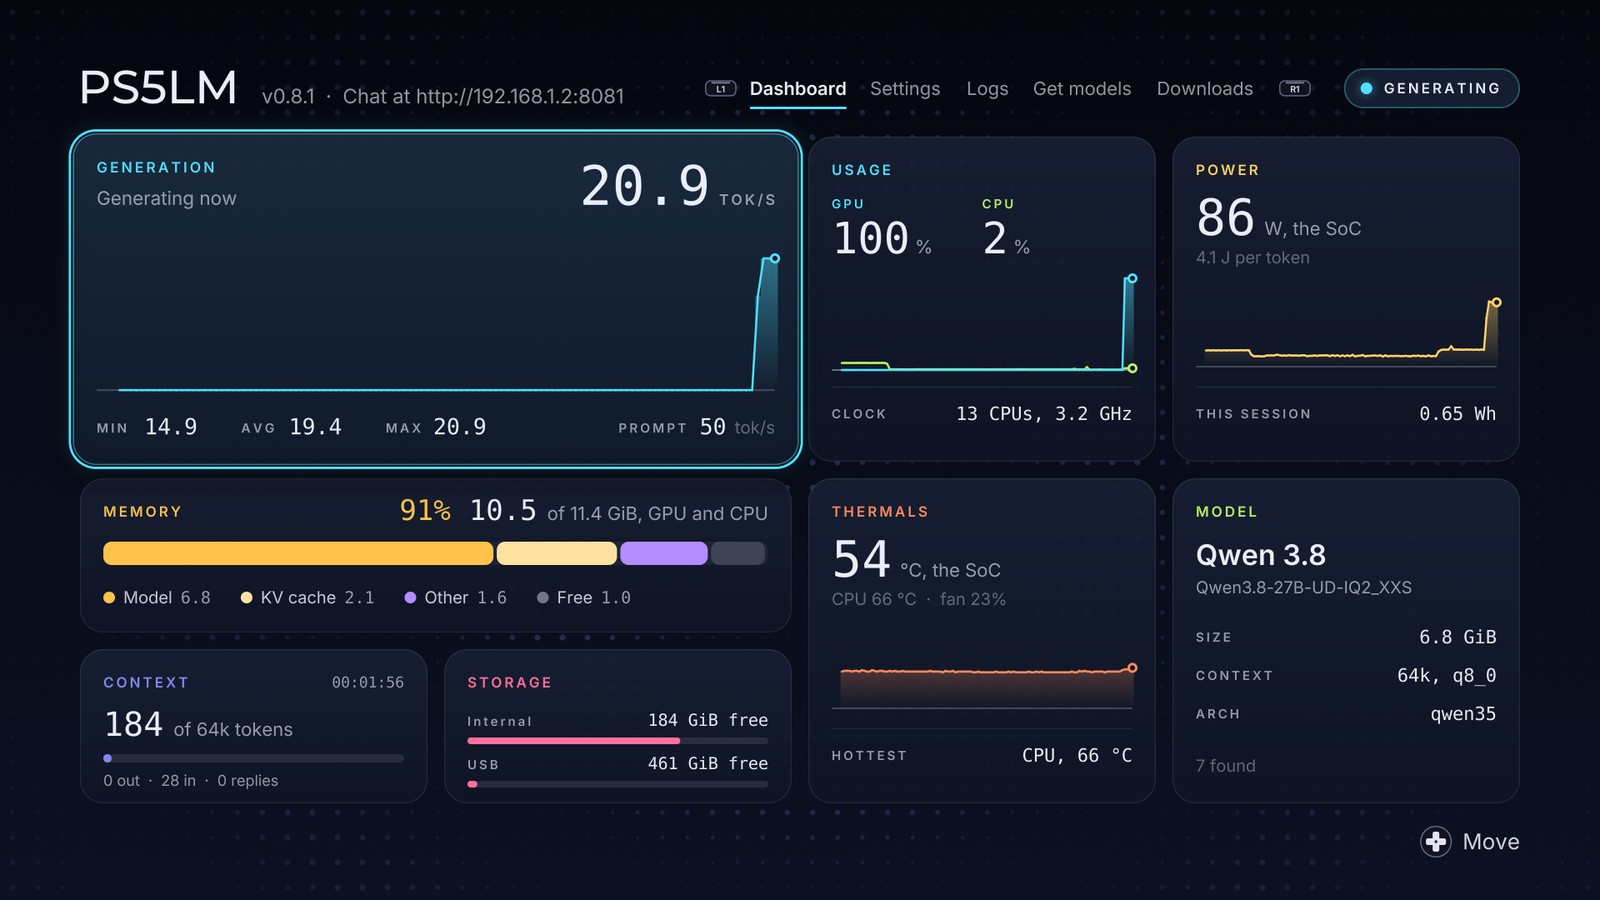
索尼PlayStation 5原本是为电子游戏设计的主机,但一项开源开发项目正在尝试挖掘这台游戏设备的另一种用途:运行本地人工智能大语言模型。开发者通过破解PS5的系统限制,将开源推理引擎llama.cpp移植到主机上,并进一步利用其GPU运行大模型。最新演示显示,一台破解后的普通PS5已经能够运行拥有270亿参数的Qwen 3.8模型,在采用低比特量化的情况下,文本生成速度达到每秒约20个Token。
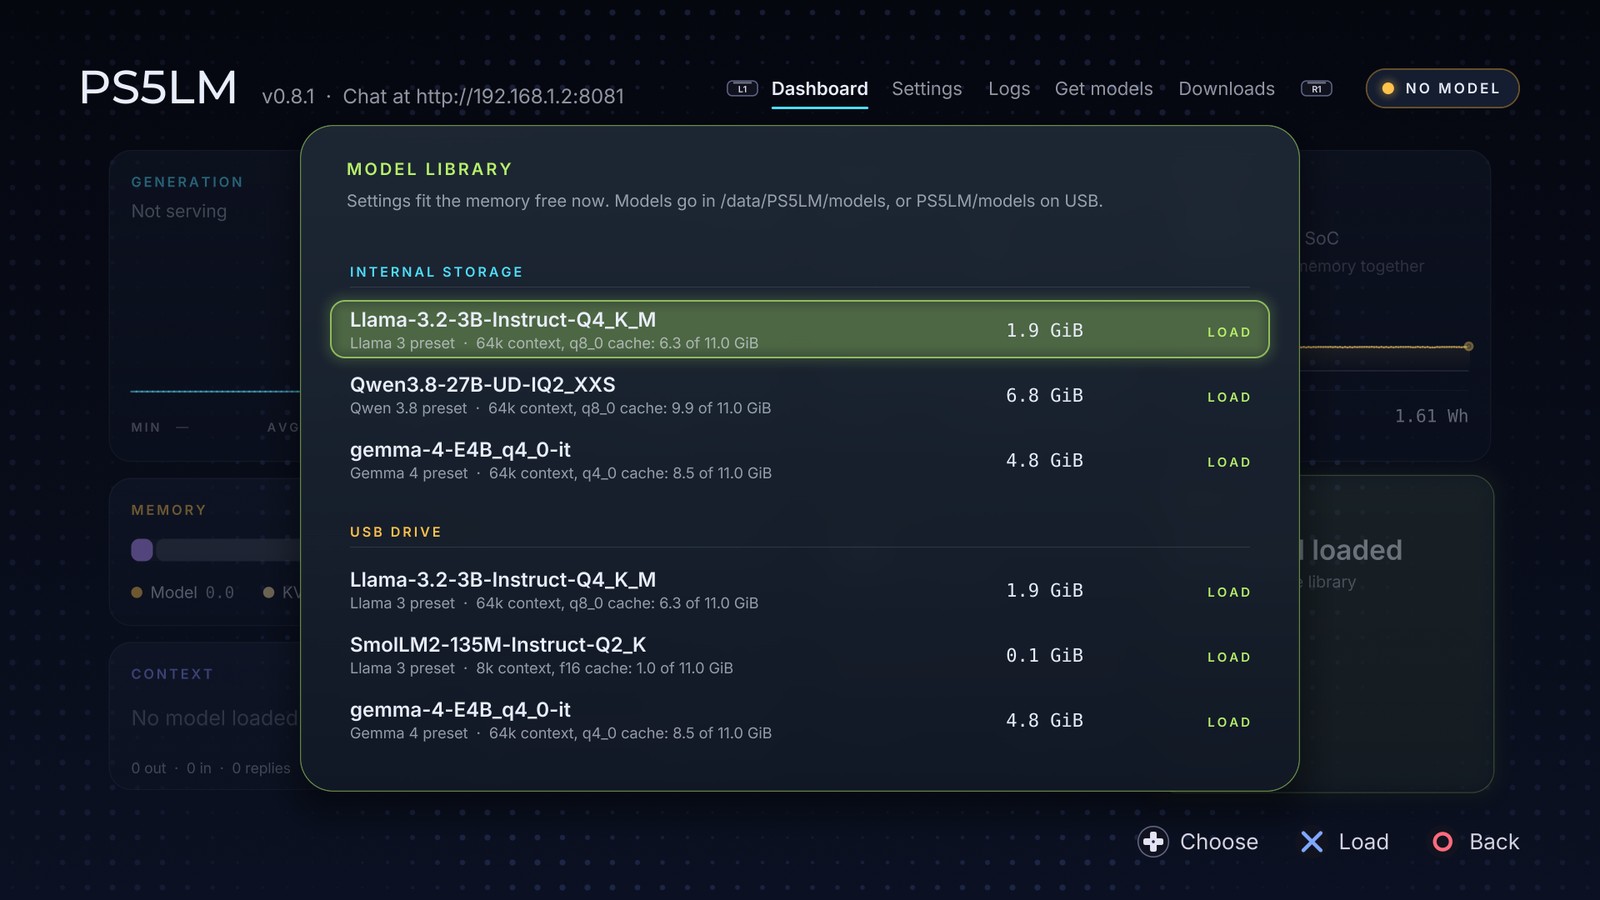
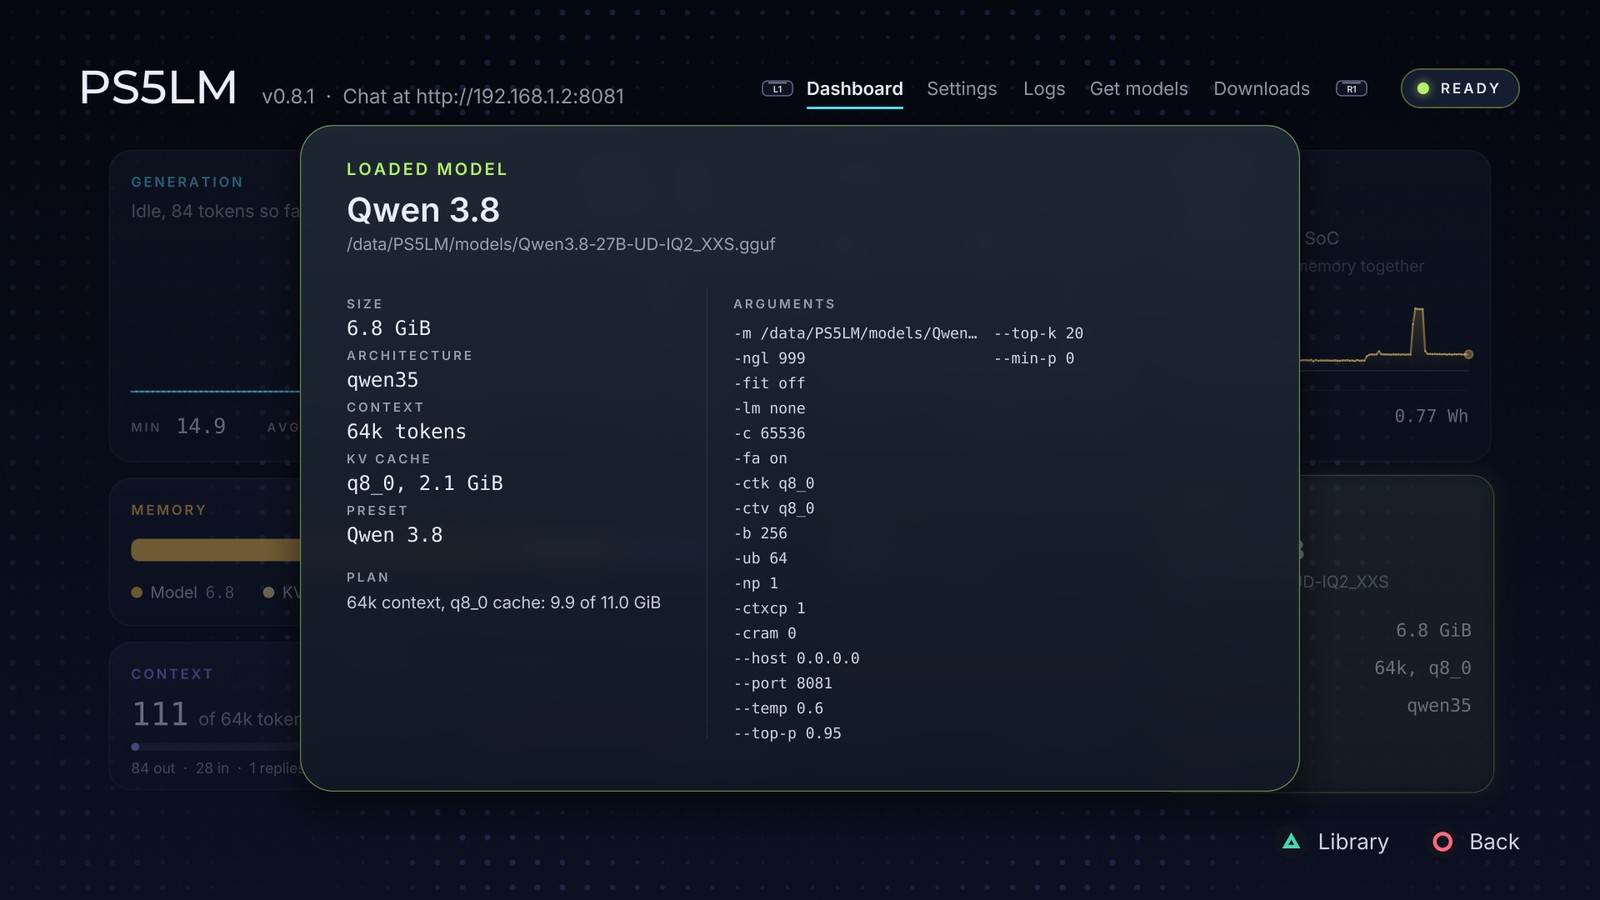
这意味着,原本主要用于运行游戏的主机,也可以在不依赖云端AI服务的情况下,充当一台本地大语言模型服务器。用户可以通过同一局域网内的电脑或手机访问主机上的服务,与模型进行对话。不过,这并不是索尼官方提供的功能,而是依赖系统漏洞、非官方软件和社区开发成果实现的实验性应用。
该项目名为PS5LM,由GitHub开发者cobanov发起。项目的核心思路并不是从头编写一套全新的人工智能推理框架,而是将已经广泛用于本地大模型运行的开源工具llama.cpp移植到PS5平台,再逐步解决主机操作系统、内存分配和GPU计算接口方面的兼容性问题。
PS5使用AMD定制处理器,CPU采用Zen 2架构,拥有8个核心;GPU则基于AMD RDNA架构。主机配备16GB GDDR6统一内存,CPU和GPU需要共享这部分资源。虽然PS5并不是专门为人工智能推理设计的设备,但其GPU和高带宽显存为运行本地语言模型提供了硬件基础。
PS5LM最初采用相对简单的运行方式,让语言模型通过主机CPU执行推理,并利用PS5自身的浏览器提供聊天界面。用户可以在主机上下载模型,通过DualSense手柄和屏幕键盘输入问题,再查看模型生成的回答。
这一早期版本证明了PS5能够运行大语言模型,但很快遇到了性能和内存方面的限制。由于程序以载荷(payload)的形式运行,能够使用的内存受到系统环境约束,最初只能稳定运行体积较小的模型。项目文档显示,早期版本主要支持约0.8B和2B参数规模的模型,其中2B模型的生成速度约为每秒9个Token。
对于希望在PS5上运行更大模型的开发者而言,仅仅让程序在CPU上运行远远不够。要充分利用主机的硬件性能,就必须让推理引擎能够调用GPU,并获得足够的内存空间来存放模型参数、缓存和其他运行数据。
真正的突破来自GPU加速。开发者在PS5上进一步实现了原生应用运行环境,并通过社区开发的图形驱动和Vulkan计算接口,让llama.cpp能够调用主机GPU执行神经网络计算。相比早期只能依赖CPU的方案,这一改变不仅提高了推理速度,也使程序能够获得更多可用内存,从而尝试运行规模更大的模型。
在最新演示中,PS5成功运行了阿里巴巴通义千问团队推出的Qwen 3.8 27B模型。该模型拥有270亿参数,采用混合注意力架构,设计目标是在相对有限的硬件资源上提供较强的语言理解、推理和代码生成能力。
不过,PS5并不是将270亿个参数以完整精度直接装入内存。为了让模型适应主机的硬件条件,开发者使用了低比特量化技术,将模型参数压缩到更小的存储空间。演示采用的IQ2_XXS等量化版本,模型文件约为数GB至7GB左右,具体大小取决于量化方案。
量化是本地大模型运行中的关键技术。通常情况下,模型参数会使用较高精度的数据格式存储,但这会占用大量内存。通过将参数压缩为更低位宽的数值,可以显著降低内存需求,并减少推理时的数据传输量。代价则是部分精度信息会丢失,可能影响模型的回答质量、推理能力或特定任务表现。因此,能够运行270亿参数模型,并不等于PS5可以在完整精度下运行同样规模的模型。
开发者公布的测试数据显示,在利用GPU执行推理时,Qwen 3.8 27B的文本生成速度可以达到每秒约20个Token。Token是大语言模型处理文本的基本单位,并不严格等同于一个汉字或一个英文单词,因此不能简单地将每秒20个Token理解为每秒生成20个汉字。不过,这一速度已经足以让交互式对话具有一定的实用性,而不再只是证明模型能够启动的技术演示。
除Qwen模型外,同一项目还公布了其他模型的测试成绩。Gemma 4 E4B的生成速度约为每秒61个Token,而Llama 3.2 3B则达到每秒约124个Token。小模型拥有更少的参数,需要进行的计算和数据读取也相对较少,因此通常能够获得更高的生成速度。
这些成绩仍应被视为开发者在特定软硬件配置下公布的测试结果,而不是经过统一测试平台验证的行业基准。不同模型的参数规模、量化方式、上下文长度和计算任务各不相同,不能只根据每秒生成的Token数量,就判断它们的综合能力孰强孰弱。
项目还展示了将PS5改造成局域网AI服务器的可能性。通过在主机上运行兼容OpenAI API的服务接口,其他设备可以经由同一网络发送请求,并获取模型生成的回答。这样一来,用户不必始终面对电视屏幕操作主机,也可以通过电脑或手机调用PS5上的本地模型。
这种方式对于希望在家庭网络中部署本地AI服务的用户具有一定吸引力。模型在本机运行时,日常对话内容原则上不需要发送给第三方云端AI服务,用户也不必按照调用次数支付云端推理费用。不过,实际隐私保障仍取决于所安装的软件、网络配置以及设备是否存在其他数据传输行为,不能仅凭“本地运行”就认定系统绝对安全。
与此同时,PS5LM的开发仍然依赖一系列非官方技术。用户需要拥有能够运行相关破解程序的PS5,并使用兼容的系统固件和载荷加载工具。项目文档列出的适用固件范围为7.00至13.60,但具体功能、性能和兼容性可能因主机型号及软件版本而有所不同。
破解主机并不意味着所有PS5用户都可以直接安装该程序。普通零售版PS5无法像安装常规游戏那样,通过PlayStation Store下载并运行PS5LM。用户需要先解决系统访问权限、非官方程序加载和运行环境等问题,这对不熟悉主机破解及软件开发的用户而言仍存在一定门槛。
此外,修改主机系统可能带来安全和稳定性风险,也可能影响在线服务的使用,并涉及索尼的相关服务条款。开发者建议只在自己拥有或获得授权的设备上开展相关研究。对于主要用于正常游戏、尤其是经常连接PlayStation Network的主机用户而言,没有必要仅为了运行本地AI而贸然破解设备。
从硬件角度来看,这项实验的意义并不只是让游戏主机能够回答问题。它进一步说明,消费级游戏设备所搭载的GPU和高速显存,在经过适当的软件适配后,也可以承担部分原本通常由专用AI计算设备完成的工作。
大语言模型推理往往受到内存容量和带宽的显著影响。模型生成文本时,需要持续读取大量参数,并维护与上下文有关的缓存。PS5的统一内存架构可以让CPU和GPU共享高速内存资源,但系统本身也需要占用其中一部分,因此可用于模型的空间远小于16GB这一标称容量。
这也是为什么开发者必须同时解决量化、内存管理和GPU计算接口等问题。单纯拥有足够强大的GPU,并不能保证一个模型就能顺利运行;模型架构是否得到支持、驱动是否能够执行所需计算操作,以及系统是否能为推理程序提供足够内存,都会影响最终结果。
这项成果也为本地AI硬件的选择提供了一个有趣的参照。传统上,希望在家中运行较大语言模型的用户,往往需要购买配备独立显卡的电脑,并为显存容量和整机成本付出额外费用。PS5则已经拥有相对强大的GPU和高速内存,因此开发者希望证明,现有游戏硬件也可以被重新利用,而不必专门购买一台AI工作站。
但这并不意味着PS5可以全面取代AI电脑。它的硬件资源仍然受到固定配置、系统占用和非官方软件环境的限制。与具备更大显存、成熟驱动和丰富开发工具的电脑相比,PS5运行大模型需要更多底层适配工作,用户也无法像使用普通AI电脑那样自由升级显卡或扩展显存。
从实际用途看,这类项目目前更适合技术爱好者、开源开发者和对本地AI感兴趣的用户,用于研究模型推理、GPU计算和嵌入式运行环境。对于需要稳定运行生产级AI服务的企业而言,专用GPU服务器或经过成熟软件栈优化的电脑仍然更为合适。
PS5LM的发展也体现了开源AI生态的一种趋势:模型推理框架和开放权重模型逐渐降低了运行人工智能的门槛,而社区开发者则不断尝试将这些工具移植到不同硬件平台。过去,游戏主机主要被视为封闭的娱乐设备;如今,在破解和逆向工程社区的努力下,它们也成为探索GPU计算和本地人工智能应用的平台。
总体而言,让一台破解后的PS5以每秒约20个Token的速度运行270亿参数的大语言模型,是一次颇具代表性的技术尝试。它展示了游戏主机硬件的潜在用途,也证明了通过软件适配和模型压缩,可以在非传统AI设备上运行具有一定规模的语言模型。不过,这项成果目前仍属于依赖破解环境的社区项目,距离普通用户无需复杂操作即可使用的官方功能,还有相当大的距离。